Курс по нейросетям для начинающих
Научитесь ставить задачи искусственному интеллекту и проверять его ответы
- 1Как устроены нейросети — без мистики
- 2Как просить текст
- 3Проверка фактов и «галлюцинации»
- 4Картинки
- и ещё этапов: 4
Онлайн-инструмент для распознавания текста на фотографиях, сканах и PDF. Нейросетевой движок читает документ прямо в браузере на русском, английском и ещё более чем 100 языках, сам разворачивает повёрнутые снимки и выпрямляет строки на фото с телефона; результат — редактируемый текст, Word, Excel или PDF с невидимым текстовым слоем для поиска.
Перетащите изображения или PDF, сфотографируйте документ камерой телефона или вставьте скриншот из буфера по Ctrl+V.
Стандартно распознаются язык сайта и английский; для других документов выберите до трёх языков из сгруппированного списка.
Простой текст для копирования, «Сохранить разметку» для документов, «Извлечь таблицы» для Excel, «Чек» — для сумм, дат и продавцов.
Осмотрите рамки, поправьте слова с низкой уверенностью прямо на месте, ищите нужные фрагменты.
Скачайте как TXT, DOCX, XLSX или PDF с поиском — или упакуйте весь пакет в ZIP.
Курс по нейросетям для начинающих
Научитесь ставить задачи искусственному интеллекту и проверять его ответы
Аудио в текст
Превратите запись разговора в читаемый документ: кто что сказал и когда
Сейчас популярно
Перетащите изображения или PDF сюда
Или нажмите Ctrl+V, чтобы вставить скриншот
Включите для некачественных сканов, фото с телефона или чеков с шумом.
Все файлы уже распознаны с этими настройками. Смените язык или стиль вывода — и кнопка распознает их заново.
Кликните по рамке, чтобы перейти к слову · кликните по слову, чтобы подсветить рамку · Редактируйте любое слово прямо в тексте — правки попадут в экспорт.
Снимок страницы и текст, который точный режим вернул по ней, — дословно и без правок, вместе с ошибками.
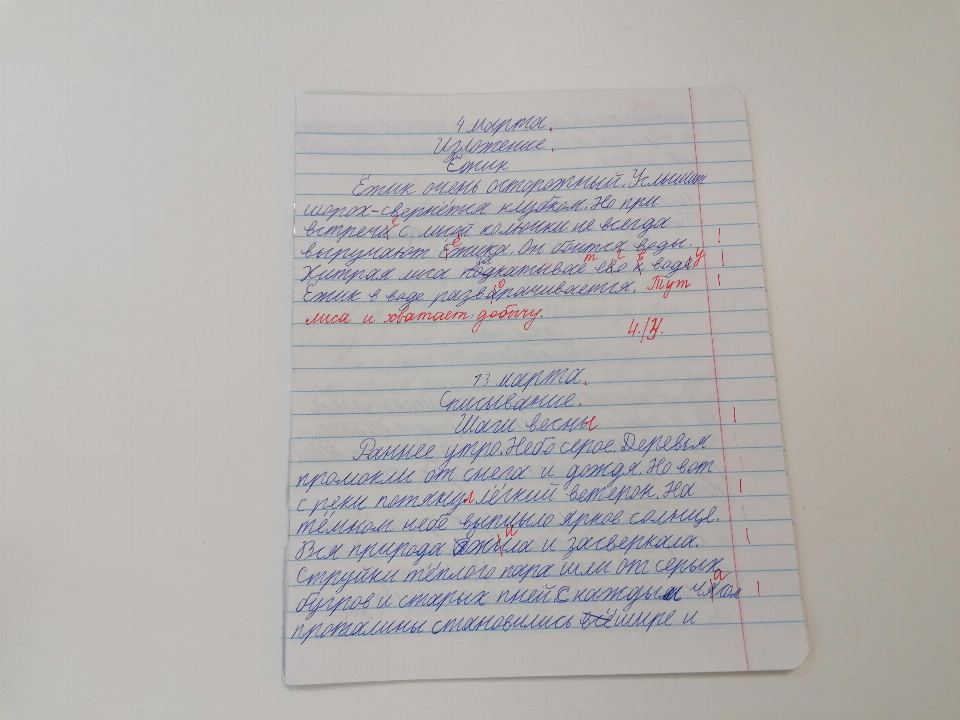
4 марта.
Изложение.
Ёжик
Ёжик очень осторожный. Услышит
шорох - свернётся клубком. Но при
встрече с лисой колючки не всегда
выручают ёжика. Он боится воды.
Хитрая лиса подкатывае его к воде. У
Ёжик в воде разворачивается. Тут
лиса и хватает добычу.
4/3.
13 марта.
Списывание.
Шаги весны
Раннее утро. Небо серое. Деревья
промокли от снега и дождя. Но вот
с реки потянул лёгкий ветерок. На
тёмном небе выплыло яркое солнце.
Вся природа ожила и засверкала.
Струйки тёплого пара шли от серых а
бугров и старых пней с каждым часом
проталины становились всё шире и
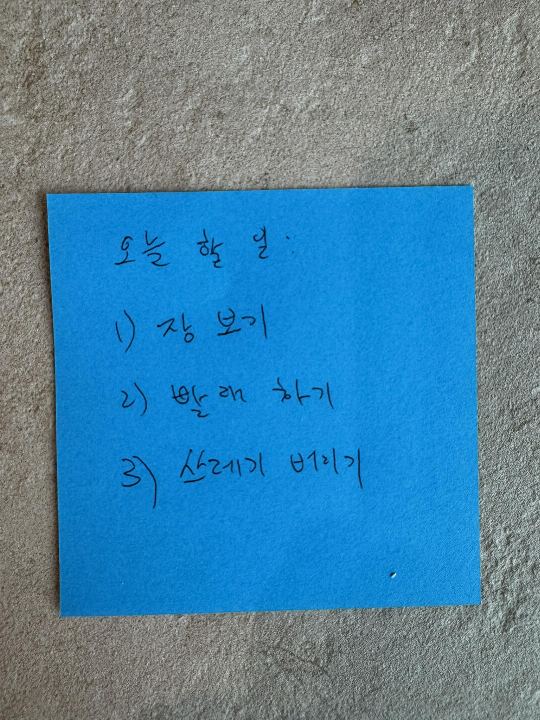
오늘 할 일 :
1) 장 보기
2) 빨래 하기
3) 쓰레기 버리기
Курс по нейросетям для начинающих
Научитесь ставить задачи искусственному интеллекту и проверять его ответы
Аудио в текст
Превратите запись разговора в читаемый документ: кто что сказал и когда
Ввод: JPG, PNG, WebP, TIFF, BMP, HEIC, PDF (многостраничный). Вывод: TXT, DOCX, XLSX, PDF с поиском, Markdown, JSON с координатами слов.
Чистый печатный текст распознаётся почти без ошибок; фото с телефона и блёклые сканы сложнее. Движок сам разворачивает повёрнутые снимки и читает каждую строку в её собственной наклонной рамке, а неуверенные слова подсвечены, чтобы их можно было поправить перед экспортом.
Русский, английский и другие языки на кириллице и латинице, китайский, японский, корейский, арабский, греческий, хинди и тайский читает нейросетевой движок; ещё около сотни языков — иврит, грузинский, вьетнамский, бенгальский и другие — распознаёт Tesseract. Языки сгруппированы по письменности; модели загружаются при первом использовании и остаются в кэше браузера.
Да. Многостраничные PDF рендерятся постранично через pdf.js, затем проходят OCR. Можно также экспортировать результат обратно в PDF с невидимым текстовым слоем — Ctrl+F работает, и скрин-ридеры читают документ.
Обычный режим настроен на печатный текст: разборчивый почерк с отдельными буквами он часто читает, курсив — нет. Для рукописи есть «Распознать точнее»: страница отправляется на сервер распознавания и читается моделью для почерка. На страницах школьных тетрадей она верно прочитала почти 9 слов из 10, обычный режим — меньше 1 из 10.
После распознавания мы группируем слова по вертикали в строки, делим строки на столбцы по горизонтальным промежуткам. Если минимум три строки имеют одинаковое число столбцов — считаем это таблицей и экспортируем как строки-столбцы в Excel. Иначе Excel получает одну колонку текста.
В очередь можно положить до 50 файлов. Сколько файлов распознаётся за сутки и сколько страниц PDF берётся за один проход, показывает блок над кнопкой «Извлечь текст». Размер файла подстраивается под устройство (примерно от 80 МБ на телефонах до 1 ГБ на компьютерах); PDF обрабатываются постранично, а у большого документа выбирается диапазон страниц.
Мы можем! Просто отправьте нам сообщение с вашим пожеланием. Если хотите обсудить детали — оставьте свою почту, и мы с вами свяжемся. Можно анонимно.
Загружая контент, вы подтверждаете, что вправе передавать его содержимое третьим лицам, и обязуетесь не включать в него персональные данные третьих лиц. Подробнее — в Условиях использования. ИИ-провайдеры Timbrica — независимый продукт. Мы не связаны с создателями перечисленных моделей и сервисов, не одобрены и не спонсируемы ими; их названия указаны лишь для того, чтобы честно сказать, какой движок работает в каком инструменте.
Расскажите о проблеме или предложите улучшение. Мы обязательно всё прочитаем!
Ваше сообщение отправлено. Мы обязательно его рассмотрим.
Оплата через СБП · ₽
Откройте приложение банка, выберите «Оплатить по QR» и наведите камеру на код.
Открыть приложение банкаЖдём подтверждения от банка…
Открыть ссылку на оплату